függelék C — Valószínűségszámítási és statisztikai alapok
Az adatbányászat módszerei bizonytalan, zajos adatokból következtetnek, ezért nyelvük a valószínűségszámítás és a statisztika. Ez a függelék a könyvben használt fogalmakat foglalja össze: a valószínűségi változókat és eloszlásaikat, a feltételes valószínűséget és a Bayes-tételt, a többdimenziós normális eloszlást, a paraméterbecslést (különösen a maximum-likelihood módszert), valamint a konfidenciaintervallumokat, a hipotézisvizsgálatot és a bootstrapet. Részletesebb, a gépi tanulás szemszögéből írt tárgyalás Wasserman (2004) és Deisenroth és mtsai. (2020) könyvében található.
C.1 Valószínűségi változók és eloszlások
A valószínűségi változó egy véletlen kísérlet kimeneteléhez rendelt szám. Diszkrét változónál a \(P(X = k)\) valószínűségek, folytonosnál a \(p(x)\) sűrűségfüggvény írja le az eloszlást (utóbbinál \(P(a\le X\le b) = \int_a^b p(x)\,dx\)). A várható érték és a variancia
A várható érték lineáris: \(E[aX + bY] = aE[X] + bE[Y]\); a variancia független változókra additív: \(\operatorname{Var}(X + Y) = \operatorname{Var}(X) + \operatorname{Var}(Y)\). Két változó kovarianciája\(\operatorname{Cov}(X, Y) = E[(X - E[X])(Y - E[Y])]\), a korrelációs együttható ennek a szórások szorzatával normált változata, \(-1\) és \(1\) közötti érték, amely a lineáris kapcsolat erősségét méri (4. fejezet).
A könyvben előforduló legfontosabb eloszlások:
táblázat C.1.. A könyvben használt fontosabb eloszlások.
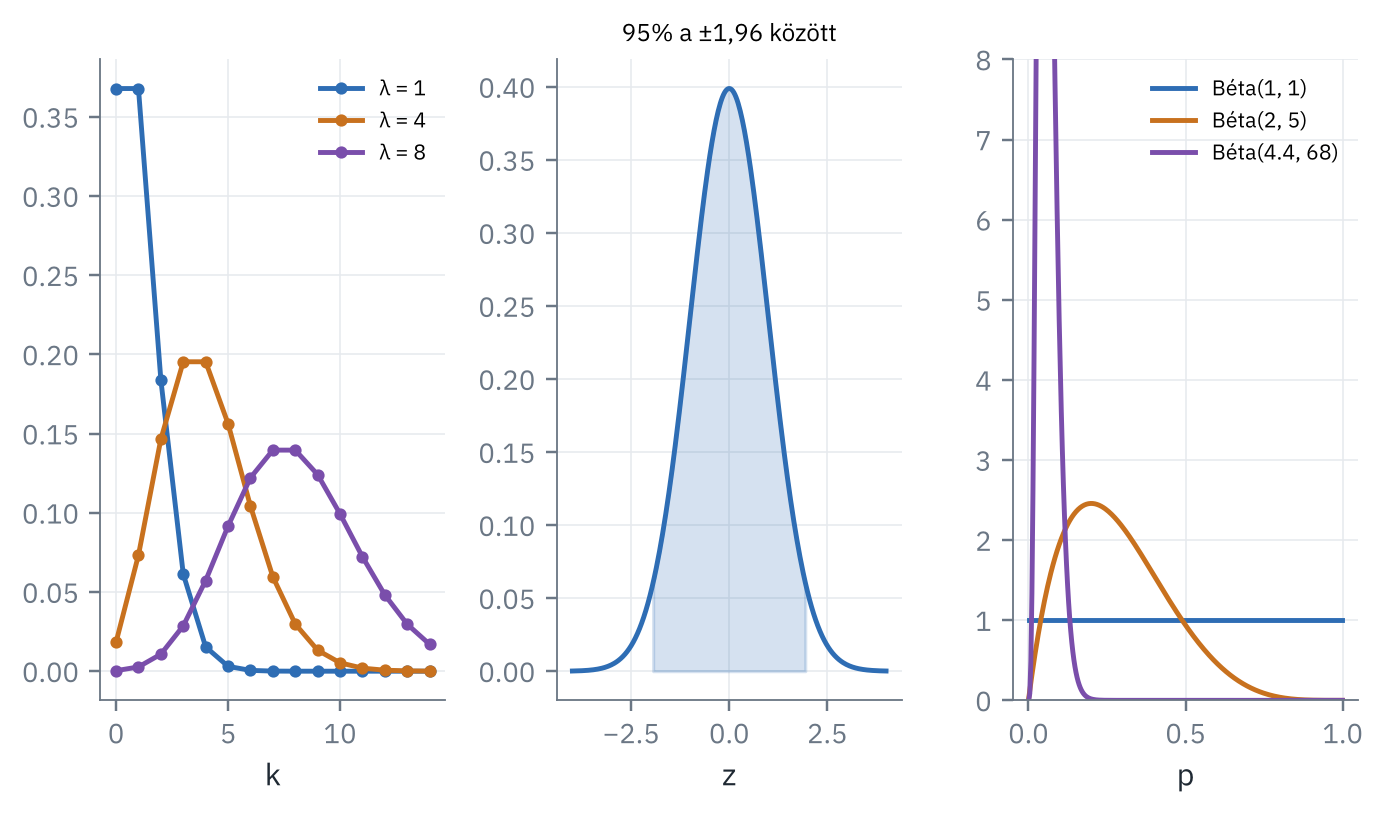
ábra C.1.. Néhány eloszlás: Poisson-eloszlás három intenzitással (balra), normális eloszlás sűrűségfüggvénye (középen) és béta-eloszlások (jobbra).
C.2 Feltételes valószínűség és a Bayes-tétel
Az \(A\) esemény \(B\) feltétel melletti feltételes valószínűsége\(P(A\mid B) = P(A\cap B)/P(B)\). Két esemény független, ha \(P(A\cap B) = P(A)P(B)\), vagyis ha \(B\) bekövetkezése nem változtat \(A\) valószínűségén. A teljes valószínűség tétele és a Bayes-tétel:
A Bayes-tétel a „fordított” következtetés eszköze: a megfigyelt adatokból (\(B\)) a rejtett okokra (\(A_i\)) következtet, az a priori valószínűségeket a megfigyelés fényében a posteriori valószínűségekké frissítve. A naiv Bayes-osztályozó (9. fejezet) és a BG/NBD modell aktív-valószínűsége (14. fejezet) is ezen alapul.
Egy klasszikus példa megmutatja, miért fontos az alapgyakoriság. Egy anomália-észlelő a csalások 95%-át jelzi, a normál rendeléseknek pedig 2%-ánál ad téves riasztást. Ha a rendelések 0,2%-a csalás, mekkora valószínűséggel csalás egy jelzett rendelés?
A jelzett rendeléseknek mindössze mintegy 9%-a csalás: ritka eseményeknél még egy pontos detektor riasztásainak többsége is téves – ezért a 11. fejezetben az AUC helyett a pontosságot és a lista elején mért találati arányt figyeltük.
C.3 A többdimenziós normális eloszlás
Az \(n\)-dimenziós normális eloszlás sűrűségfüggvénye
ahol \(\boldsymbol\mu\) a várhatóérték-vektor, \(\boldsymbol\Sigma\) a kovarianciamátrix. A kitevőben a Mahalanobis-távolság négyzete áll (11. fejezet); a sűrűség szintvonalai ellipszoidok, amelyek tengelyeit \(\boldsymbol\Sigma\) sajátvektorai adják (B. függelék). Ha \(\mathbf{x}\)\(n\)-dimenziós normális eloszlású, \(d_M^2\)\(\chi^2_n\) eloszlású – ez adja a Mahalanobis-távolságon alapuló küszöböket. A normális eloszlás lineáris transzformációja is normális, peremeloszlásai és feltételes eloszlásai is normálisak; a Gauss-keverék modellek (5. fejezet) ilyen eloszlások súlyozott összegei.
A nagy számok törvénye szerint a mintaátlag a várható értékhez tart, a centrális határeloszlás-tétel szerint pedig sok független, azonos eloszlású változó átlaga – eloszlásuktól függetlenül – közelítőleg normális eloszlású, \(\sigma/\sqrt{N}\) szórással. Ez magyarázza a normális eloszlás kitüntetett szerepét a mérési hibák leírásában és a statisztikai próbákban.
C.4 Paraméterbecslés
C.4.1 Becslők tulajdonságai
Egy \(\hat\theta\) becslő torzítatlan, ha \(E[\hat\theta] = \theta\), és konzisztens, ha a mintaméret növelésével a valódi értékhez tart. A becslő átlagos négyzetes hibája a torzítás négyzetének és a varianciának az összege – ez a 7. fejezet torzítás–variancia felbontásának statisztikai megfelelője. A variancia \(\hat\sigma^2 = \frac{1}{N}\sum_i(x_i - \bar x)^2\) becslője torzított, mert a mintaátlag a mintához „igazodik”; a torzítatlan változat \(N - 1\)-gyel oszt (Bessel-korrekció):
A NumPy var és std függvényei alapértelmezésben \(N\)-nel osztanak (ddof=0), a pandas megfelelő metódusai \(N - 1\)-gyel (ddof=1); a különbség kis mintákon számít.
C.4.2 Maximum-likelihood becslés
A maximum-likelihood (ML) becslés azt a paraméterértéket választja, amely mellett a megfigyelt adatok a legvalószínűbbek. Független megfigyeléseknél a likelihood a valószínűségek (sűrűségek) szorzata, és a számításokhoz annak logaritmusát használjuk:
Bernoulli-eloszlásnál (\(k\) siker \(N\) kísérletből) a \(\ell(p) = k\ln p + (N - k)\ln(1 - p)\) függvény deriváltját nullával egyenlővé téve \(\hat p = k/N\); normális eloszlásnál \(\hat\mu = \bar x\) és \(\hat\sigma^2 = \frac1N\sum_i(x_i - \bar x)^2\) – az utóbbi a fenti torzított becslő. A könyv számos módszere ML-becslés: a legkisebb négyzetek módszere normális hibatag esetén, a logisztikus regresszió (kereszt-entrópia), a Gauss-keverék modell EM-algoritmusa, a BG/NBD és a gamma–gamma modell. Ha nincs zárt alakú megoldás, a log-likelihoodot numerikusan maximalizáljuk:
from scipy.optimize import minimize_scalarx = ab.load_plant().alarms.groupby(ab.load_plant().alarms.ido.dt.date).size()napi = x.reindex(pd.date_range("2025-01-01", "2025-12-31").date, fill_value=0).to_numpy()negloglik =lambda lam: -stats.poisson.logpmf(napi, lam).sum()ml = minimize_scalar(negloglik, bounds=(0.01, 20), method="bounded")print(f"a napi riasztásszám Poisson-intenzitásának ML-becslése: {ml.x:.3f} (a mintaátlag: {napi.mean():.3f})")print(f"átlag {napi.mean():.2f}, variancia {napi.var(ddof=1):.2f} – a Poisson-modellben a kettő egyenlő volna")
a napi riasztásszám Poisson-intenzitásának ML-becslése: 1.658 (a mintaátlag: 1.658)
átlag 1.66, variancia 5.05 – a Poisson-modellben a kettő egyenlő volna
A numerikus becslés megegyezik a zárt alakú megoldással (a mintaátlaggal). A variancia azonban jóval nagyobb az átlagnál: a riasztások csoportosan, hibaeseményekhez kötötten jelentkeznek, ezért a napi riasztásszám „túlszórt” – a Poisson-modell itt nem megfelelő, a negatív binomiális (gamma–Poisson keverék) eloszlás jobb leírást adna. A modell feltevéseinek ellenőrzése a becslés elválaszthatatlan része.
A konfidenciaintervallum a becslés bizonytalanságát fejezi ki: a 95%-os intervallum olyan eljárással készül, amely ismételt mintavételnél az esetek 95%-ában tartalmazza a valódi paramétert. Nagy mintán az átlag 95%-os intervalluma \(\bar x\pm 1{,}96\,s/\sqrt N\); két arány különbségére a 14. fejezet (14.5) képletét használtuk.
A hipotézisvizsgálat egy nullhipotézist (például „a kampánynak nincs hatása”) vet össze az adatokkal. A p-érték annak valószínűsége, hogy a nullhipotézis fennállása esetén a megfigyeltnél legalább ennyire szélsőséges eredményt kapnánk; ha kisebb az előre rögzített szignifikanciaszintnél (rendszerint 0,05), a nullhipotézist elvetjük. A p-érték nem a nullhipotézis valószínűsége, és nem a hatás nagysága: nagy mintán egy gyakorlatilag jelentéktelen különbség is szignifikáns lehet, ezért mindig a hatás nagyságát és a konfidenciaintervallumot is meg kell adni. Sok próba egyidejű elvégzésekor a véletlen „felfedezések” száma nő (többszörös összehasonlítás); ilyenkor a szignifikanciaszintet korrigálni kell (például Bonferroni-korrekcióval) – ez az asszociációs szabályok és a modellválasztás értékelésénél is fontos.
A bootstrap a becslő eloszlását az adatokból, visszatevéses újramintavételezéssel közelíti: sok bootstrap-mintán kiszámítjuk a statisztikát, és az így kapott értékek eloszlásából (például a 2,5%-os és a 97,5%-os kvantilisből) adunk intervallumot. Előnye, hogy bonyolult statisztikákra (medián, AUC, egy modell hibája) is alkalmazható, zárt alakú képlet nélkül. A 9. fejezet zsákolása (bagging) ugyanezt az újramintavételezést használja.