Ez a függelék a könyv példáinak megértéséhez és továbbfejlesztéséhez szükséges Python- ismereteket foglalja össze, programozási előismeretek nélkül is követhető módon. A nyelv alapelemei után a tudományos számítások négy alapkönyvtárát – a NumPy-t, a pandast, a Matplotlibet és a scikit-learn-t – mutatjuk be, majd a könyv saját segédcsomagját és a reprodukálható munka gyakorlatát. A részletesebb elsajátításhoz VanderPlas (2016) és McKinney (2022) könyve ajánlott.
A.1 A munkakörnyezet
A könyv minden példája három módon futtatható:
Google Colab – a böngészőben futó, telepítést nem igénylő Jupyter-környezet. A fejezetek végén található „Colab” gombok a fejezet kódját tartalmazó jegyzetfüzetet nyitják meg; az első cella telepíti a könyv segédcsomagját.
Saját gépen, Jupyterrel – a Python 3.11 vagy újabb változatának telepítése után egy virtuális környezetben:
python-m venv .venvsource .venv/bin/activate # Windows: .venv\Scripts\activatepip install -r requirements.txt # a könyv tárolójábólpip install -e . # a segédcsomag fejlesztői telepítésejupyter lab
A könyv forrásából – a tároló klónozása után a quarto render parancs a teljes könyvet újrafordítja, és közben minden kódot lefuttat.
A Jupyter-jegyzetfüzet cellákból áll: a kódcellák eredménye (szöveg, táblázat, ábra) közvetlenül alattuk jelenik meg. A cellák tetszőleges sorrendben futtathatók, ami kísérletezéshez kényelmes, de hibaforrás is: a jegyzetfüzetet a végén mindig érdemes „újraindítás és minden futtatása” paranccsal ellenőrizni.
A.2 A nyelv alapelemei
A.2.1 Változók és alapvető típusok
A Python dinamikusan típusos nyelv: a változó típusát az értéke határozza meg.
homerseklet =86.5# lebegőpontos szám (float)termekkod ="B"# karakterlánc (str)tetelszam =14# egész szám (int)megfelelo =True# logikai érték (bool)print(type(homerseklet), type(termekkod), type(tetelszam), type(megfelelo))print(f"A(z) {termekkod} termék hőmérséklete {homerseklet:.1f} °C, tételszám: {tetelszam}.")
<class 'float'> <class 'str'> <class 'int'> <class 'bool'>
A(z) B termék hőmérséklete 86.5 °C, tételszám: 14.
Az utolsó sor egy f-string: a kapcsos zárójelek közötti kifejezés értéke behelyettesítődik, a kettőspont utáni rész (.1f) a formázást adja meg. A Python a tizedesjelölésre pontot használ; a könyv szövegében – a magyar helyesírásnak megfelelően – tizedesvesszőt írunk, a kódban és a kimenetekben viszont pont szerepel.
A.2.2 Gyűjtemények
A négy beépített gyűjteménytípus a lista (rendezett, módosítható), a rendezett n-es (tuple, nem módosítható), a szótár (kulcs–érték párok) és a halmaz (egyedi elemek).
def minosit(T, termek, tures=1.5):"""Megfelel-e a hőmérséklet a termék alapjelének a tűréshatáron belül?""" elteres = T - alapjel[termek]ifabs(elteres) <= tures:return"megfelelő"elif elteres >0:return"túl meleg"else:return"túl hideg"for T in meresek:print(T, minosit(T, "B"))
82.1 túl hideg
85.3 megfelelő
86.0 megfelelő
84.7 megfelelő
87.2 megfelelő
A Pythonban a kódblokkokat a behúzás jelöli. A függvény elején álló karakterlánc a dokumentációs szöveg (docstring), amelyet a help(minosit) jelenít meg. A listaértelmezés (list comprehension) tömör és gyors módja egy lista előállításának:
elteresek = [round(T - alapjel["B"], 1) for T in meresek if T >84]print(elteresek)
[-0.7, 0.0, -1.3, 1.2]
A.3 NumPy: tömbök és vektorizált számítás
A NumPy (Harris és mtsai., 2020) alapobjektuma az azonos típusú elemekből álló, többdimenziós tömb (ndarray). A műveletek elemenként, gyorsan, C nyelven megírt ciklusokkal hajtódnak végre (vektorizálás), ezért a nagy adattömbökön végzett számításoknál a Python- ciklusok helyett tömbműveleteket használunk.
A broadcasting szabályai szerint eltérő alakú tömbök is kombinálhatók, ha a dimenzióik összeillenek; így például egy mátrix minden oszlopa egy lépésben standardizálható:
A mátrixszorzás operátora a @; a lineáris algebra további eszközei (inverz, sajátérték-felbontás, SVD) a np.linalg modulban vannak (B. függelék).
A.4 pandas: táblázatos adatok
A pandas (McKinney, 2010) két alapobjektuma a címkézett egydimenziós Series és a kétdimenziós, oszloponként eltérő típusú DataFrame. Az adatbányászati munka nagy része – beolvasás, tisztítás, szűrés, csoportosítás, összekapcsolás – pandasban történik.
A legfontosabb műveletek: read_csv/read_parquet (beolvasás), loc/iloc (címke, illetve pozíció szerinti kiválasztás), query (feltételes szűrés), assign (új oszlopok), groupby + agg (csoportos összesítés), merge (összekapcsolás, mint az SQL JOIN), pivot_table (kimutatás), resample és rolling (idősorok), isna/fillna/dropna (hiányzó értékek). A láncolt írásmód – mint a fenti példában – olvashatóvá teszi az adatfeldolgozási lépések sorozatát.
A.5 Matplotlib: ábrák
A Matplotlib (Hunter, 2007) objektumorientált felülete egy ábrából (Figure) és egy vagy több koordináta-rendszerből (Axes) áll; a könyv ábrái a segédcsomag set_style() függvényével beállított egységes stílust használják. A statisztikai ábrákhoz a seaborn (Waskom, 2021) magasabb szintű függvényeket ad.
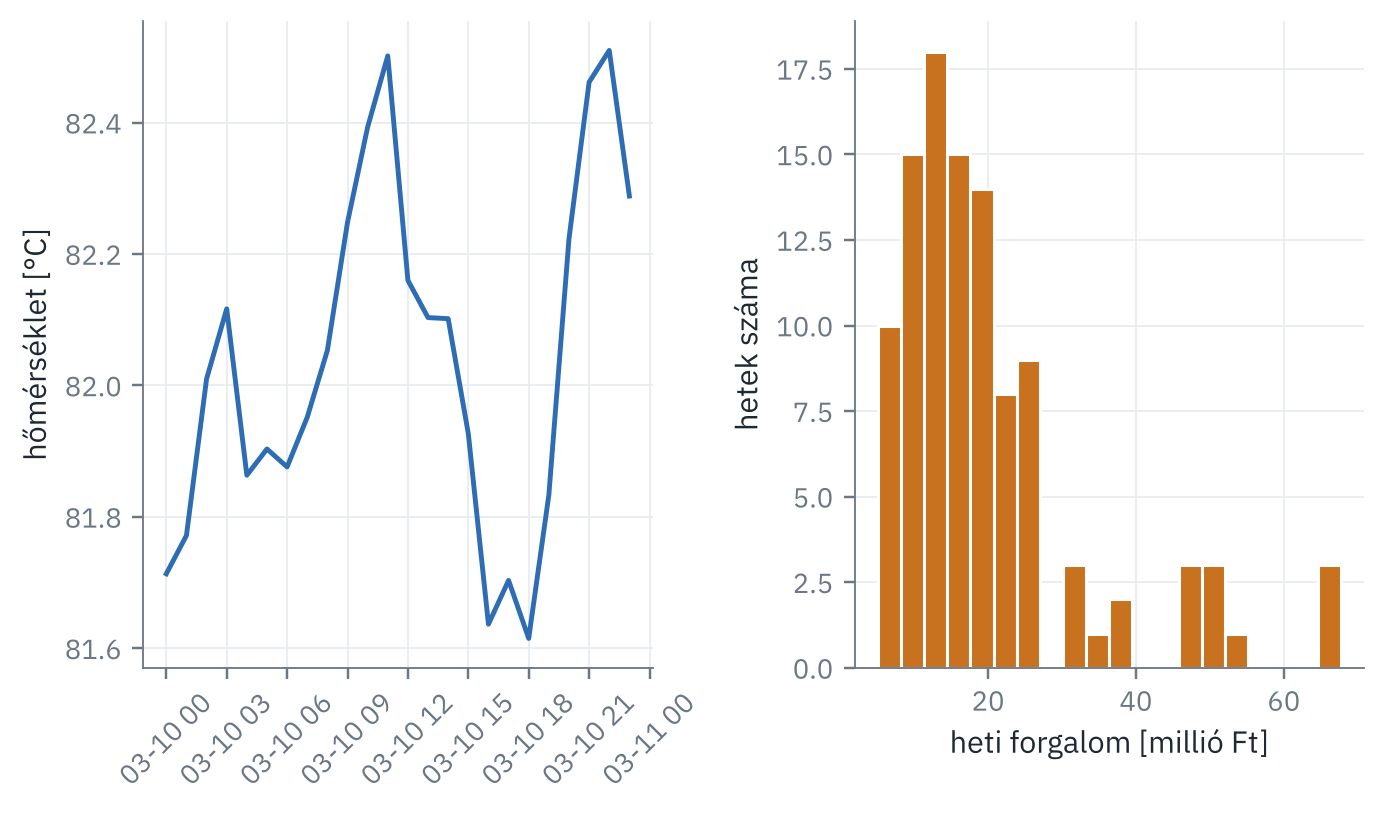
ábra A.1.. Egyszerű Matplotlib-ábra két koordináta-rendszerrel: a reaktorhőmérséklet egy napja és a heti forgalom eloszlása.
A.6 scikit-learn: a gépi tanulás egységes felülete
A scikit-learn(Pedregosa és mtsai., 2011) minden modellje ugyanazt a felületet követi: a konstruktor a hiperparamétereket kapja, a fit(X, y) tanít, a predict(X) (osztályozóknál a predict_proba(X) is) előrejelez, az előfeldolgozó lépések pedig fit és transform metódusokkal rendelkeznek. A Pipeline a lépéseket egyetlen modellé fűzi, így az előfeldolgozás paraméterei is csak a tanítóadatokból becsülődnek – ez akadályozza meg az információszivárgást (3. fejezet).
A könyv kódja az adatbanyaszat nevű segédcsomagra épül, amelyet a példák elején import adatbanyaszat as ab formában töltünk be. A csomag a szimulált futó esetek generátorait (D. függelék), a fejezeteken átívelő előfeldolgozási lépéseket és az ábrák stílusát tartalmazza; így minden fejezet ugyanazokra, a korábbi fejezetekben már megtisztított adatokra építhet.
táblázat A.1.. A segédcsomag legfontosabb függvényei.
Függvény
Tartalom
Bevezetve
ab.load_shop()
a PannonShop nyers adatai: tételek, termékek, vevők, vélemények, háttérigazság
A generátorok determinisztikusak: ugyanazzal a véletlenmaggal (alapértelmezés: 2026) mindig ugyanazokat az adatokat állítják elő, ezért a könyv minden eredménye pontosan reprodukálható.
A.8 Jó gyakorlatok
Reprodukálhatóság: rögzítsük a véletlenmagot (np.random.default_rng(mag), random_state=mag), a csomagok verzióit (requirements.txt), és a jegyzetfüzetet futtassuk végig az elejétől.
Verziókezelés: a kódot és a dokumentációt git-tárolóban tartsuk; a nagy adatfájlokat ne, azokat a generáló kód vagy egy adattár hivatkozása írja le.
Olvasható kód: beszédes változónevek, rövid függvények docstringgel, a „varázsszámok” helyett nevesített paraméterek.
Tesztelés: a kézi példák eredményeit (például egy gradiens numerikus ellenőrzését) írjuk meg automatikus tesztként is.
Jegyzetfüzet és modul: a felfedező elemzés jegyzetfüzetben, a többször használt kód modulban (.py fájlban) a helyén.
Harris, C. R. és mtsai. (2020). Array programming with NumPy. Nature, 585(7825), 357–362.
Hunter, J. D. (2007). Matplotlib: A 2D Graphics Environment. Computing in Science & Engineering, 9(3), 90–95.
McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 56–61.
McKinney, W. (2022). Python for Data Analysis (3. kiad.). O’Reilly.
Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, É. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly.
Waskom, M. L. (2021). seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021.